atom_v1 分析:可拟合的工序接近天花板,
需要设计意图的工序明显弱
1 · 逐工序结论
数值摘自对应案例页;“判断”一列是本报告的解读。点击工序名打开原案例页。
| 工序 | 用时 | 页面上的结果 | 判断 | 依据 |
|---|---|---|---|---|
| 04 建模 · MOD-03 Wave-1 运行,题面公开评测方法 | — | 形状 P95 6.71%(阈值 ≤1.5%);关键点 9.75 mm;闭眼间隙 12.7 mm | 明确失败 | 耳根块状突起、面颊折痕;沿用“参数化生成器”策略 |
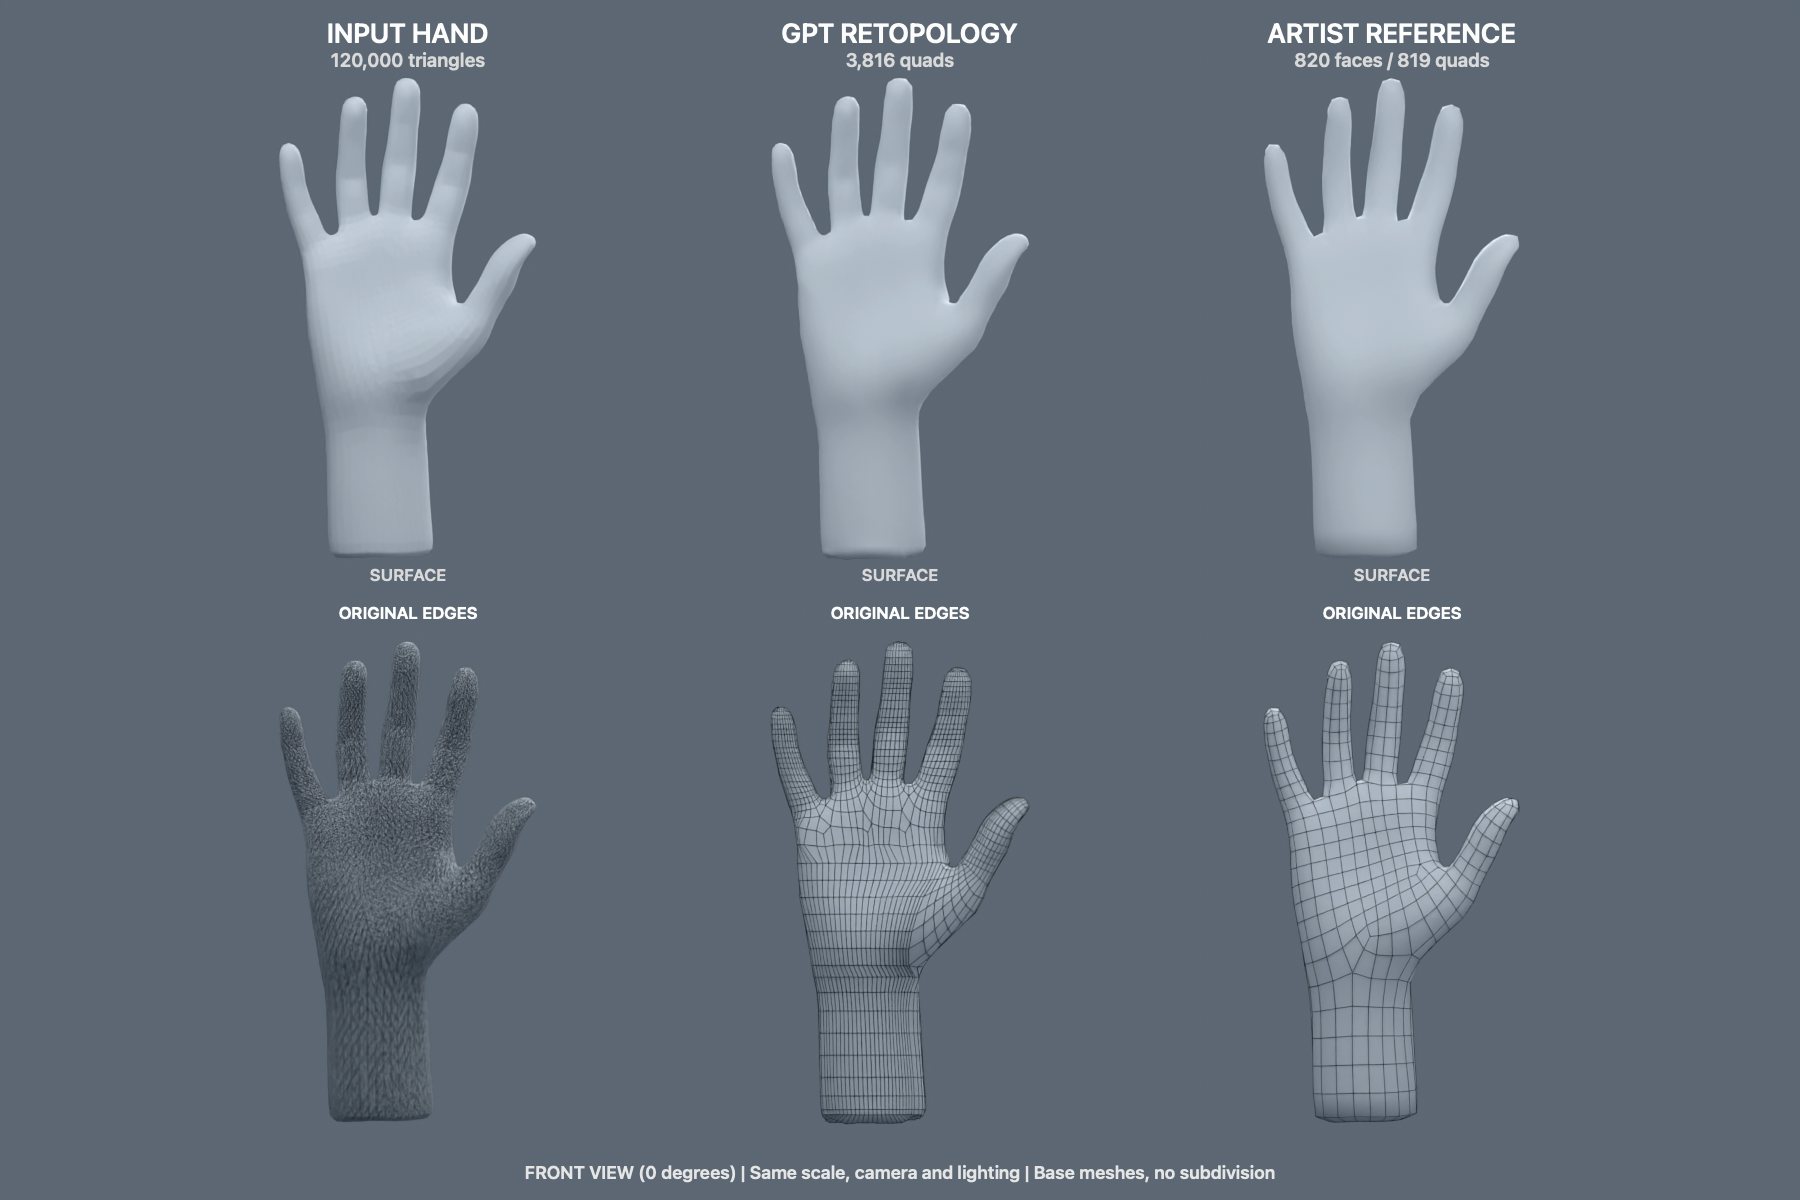
| 05 拓扑 · TOP-01 头部为 Wave-1;手部为低提示 | — | 全四边形,眼口有环 | 边流有缺口 | 方框眼环、嘴部像嵌入补片;手部 3,816 面,作者 820 面(4.7×);头部旧评测曾误判通过 |
| 06 UV · UV-A | 25.9 min | 0 个坍缩三角形,0 个越界,纹理空间利用率 51.9% | 基本可用 | 利用率偏低(作者 UV 的利用率未报);没有一键展开基线,无法判断是否超过现成工具 |
| 06 底色 · TEX-01 | 16.4 min | 三视图可见区 MAE 0.026;不可见区 0.126 | 接近天花板 | 本质是三视图投影;不可见误差主要来自眼球、头皮这类永远看不见的面,不能说明补全能力 |
| 07 材质 LookDev | 40.7 min | 交付、依赖、独立修改检查通过;外观未自动判定 | 有缺口 | 皮纹规则化、顶板反射不同;留出条件下与常数基线几乎持平(见 2.3) |
| 08 绑定 · 人体 / 人脸 | 34.7 / 36.3 min | 控制、保存重开、复位通过;形变质量 not_assessed | 比预期强 | 关键姿态与作者几乎一致;但测试动作幅度温和,没测极限动作 |
| 09 Layout · 教室 | 23.4 min | 逐组件可见 IoU 均值 0.922;22 / 22 项检查通过 | 接近天花板 | 只在参考相机下评测 |
| 10 动画 · 柴犬行走 | 18.0 min | 机械检查全部通过 | 表演未达意 | 尾巴保持中性卷环,只小幅倾摆;头部起伏小、步幅小;周期 1.33 s,比作者 1.07 s 还慢,而题面要求“轻快” |
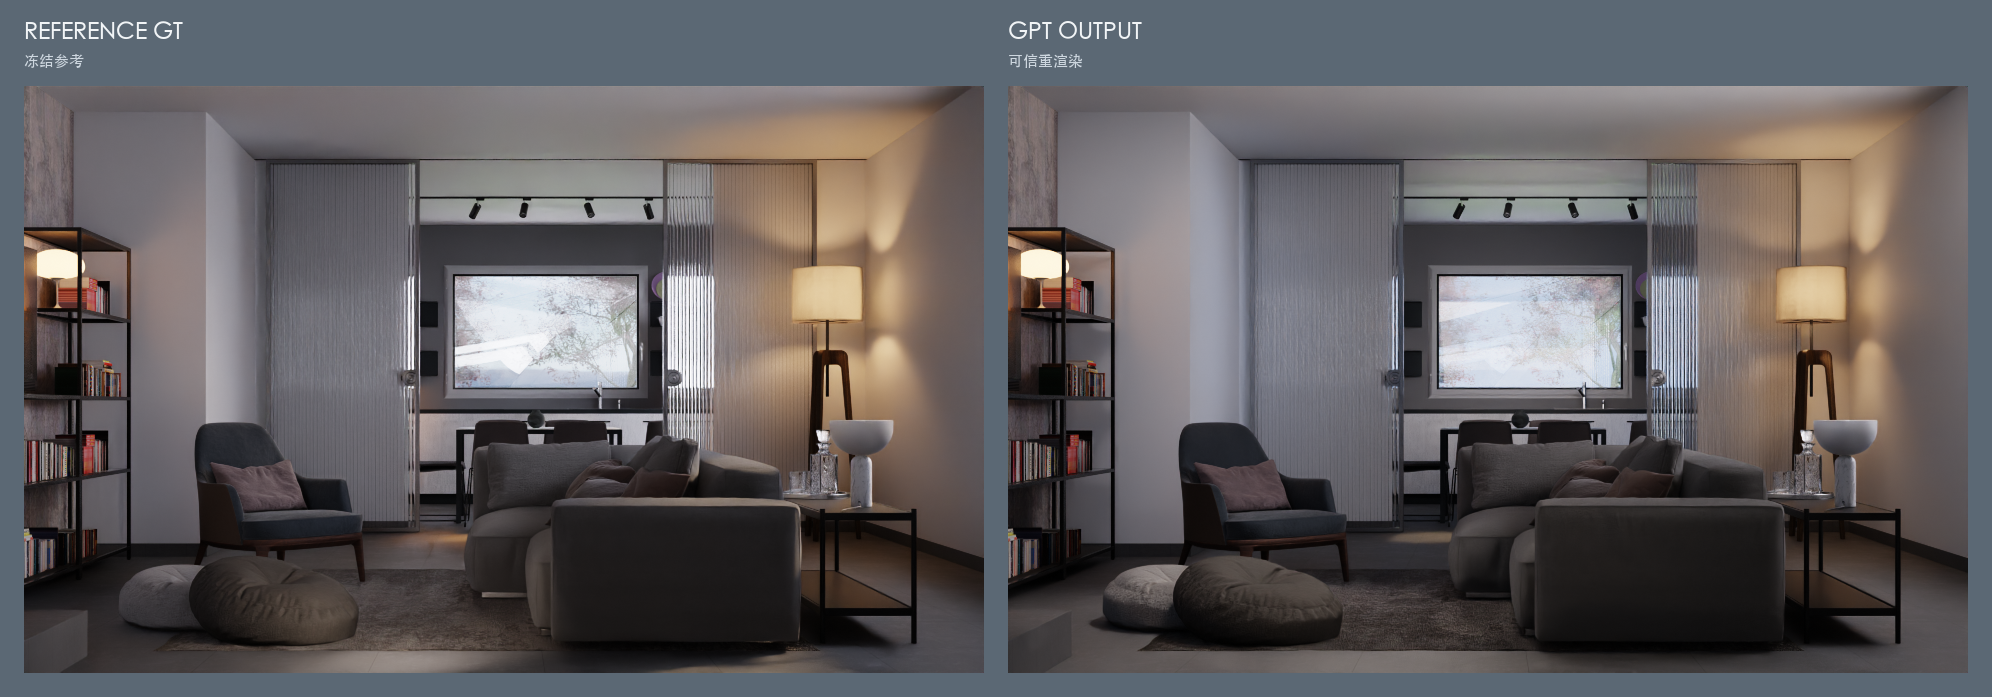
| 12 灯光 · Italian Flat | 58.5 / 60 min | 5 / 5 项预先冻结的视觉代理指标通过;照明区域 MAE 0.042 | 接近,待留出验证 | 画面被压平:参考的地面光斑、左前暗部对比消失;22 盏灯 + light linking + “基底拟合”;几乎用满预算 |
2 · 三条跨任务规律
从 8 个案例里归纳,单例证据,措辞应理解为“在这些案例中”。
能拟合的强,要意图的弱
参考给出了目标本身时(同一相机的 Layout 与灯光、三视图投影、固定模型的 UV),模型可以把任务变成拟合问题并做到很接近。目标需要从参考推断“为什么”时——布线要服务眼睑和指关节的形变、侧后方的体积要补出来、走路要显得轻快愉悦、皮革在新光照下要像皮革——结果就明显落后于作者。
这和此前的发现是同一现象:MOD-03 / TOP-01 把头部写成“参数化生成器”(圆柱网格 + 矩形孔 + 眼嘴模块),BAKE-01 “题面没写的就不做”。
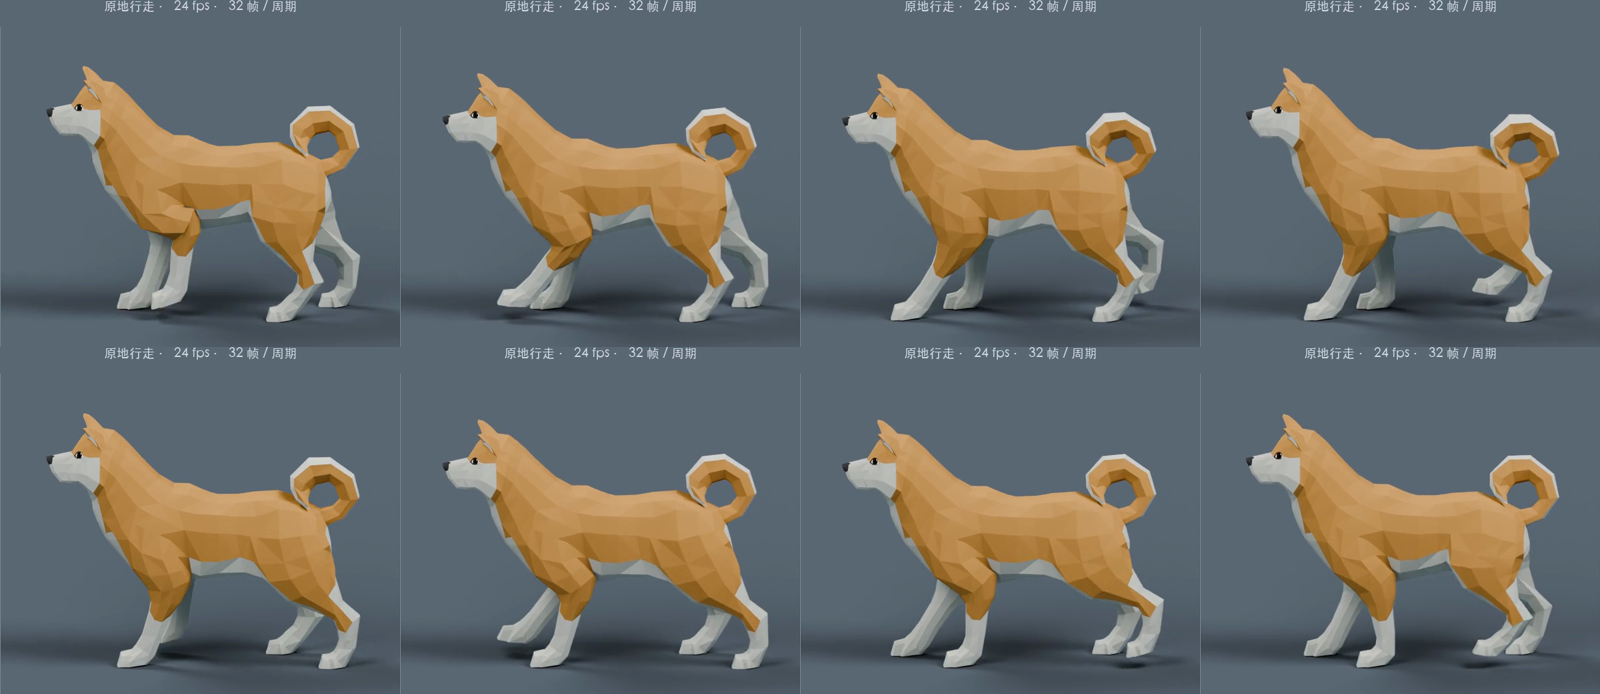
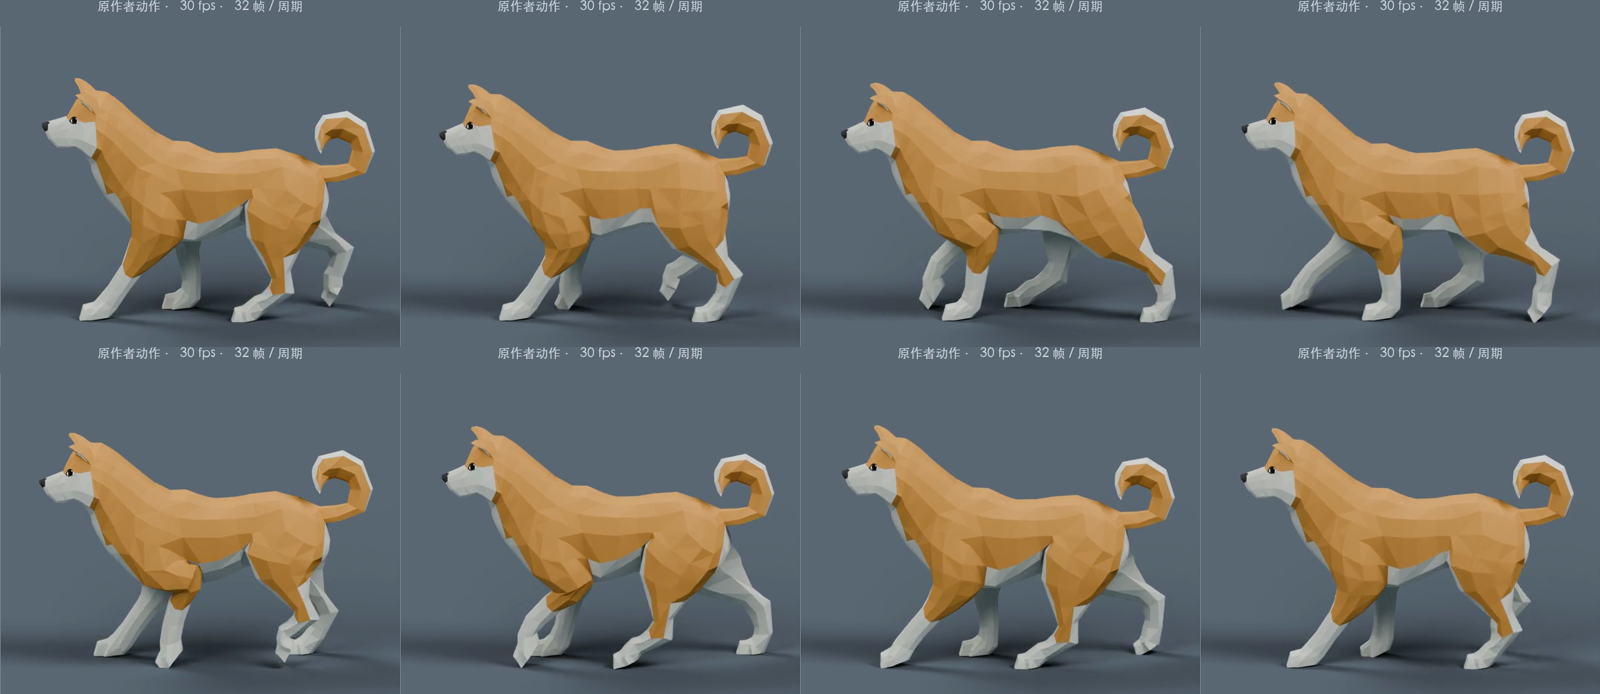
两组帧取自 atom_v1 侧视对比视频前 1.33 秒(GPT 一个周期),每 5 个展示帧取 1 帧;作者列在同一时间段内约走 1.25 个周期。
自动检查测的是合同,不是手艺
四个弱项里,只有 MOD-03 被自动判失败——因为它有隐藏参考的形状指标。其余几项,自动检查要么通过,要么没测到核心缺陷:
| 工序 | 自动结论 | 核心缺陷 | 检查抓到了吗 |
|---|---|---|---|
| 04 MOD-03 | goal fail / probe fail | 形状偏差、闭眼间隙与自交 | 抓到 |
| 05 TOP-01 头部 | 旧评测 auto_passed | 方框眼环、嘴部补片 | 误判通过 |
| 10 动画 | 机械检查通过(真实网格运动、循环接续、四足相位) | 表演不轻快、尾巴与头部缺少跟随 | 没抓到 |
| 07 材质 | 交付与独立修改通过;外观未评 | 皮纹规则化;留出条件下 ≈ 基线 | 没评 |
| 08 绑定 | 控制通过;形变 not_assessed | 极限动作下表现未知 | 没测 |
留出条件是最有效的放大镜
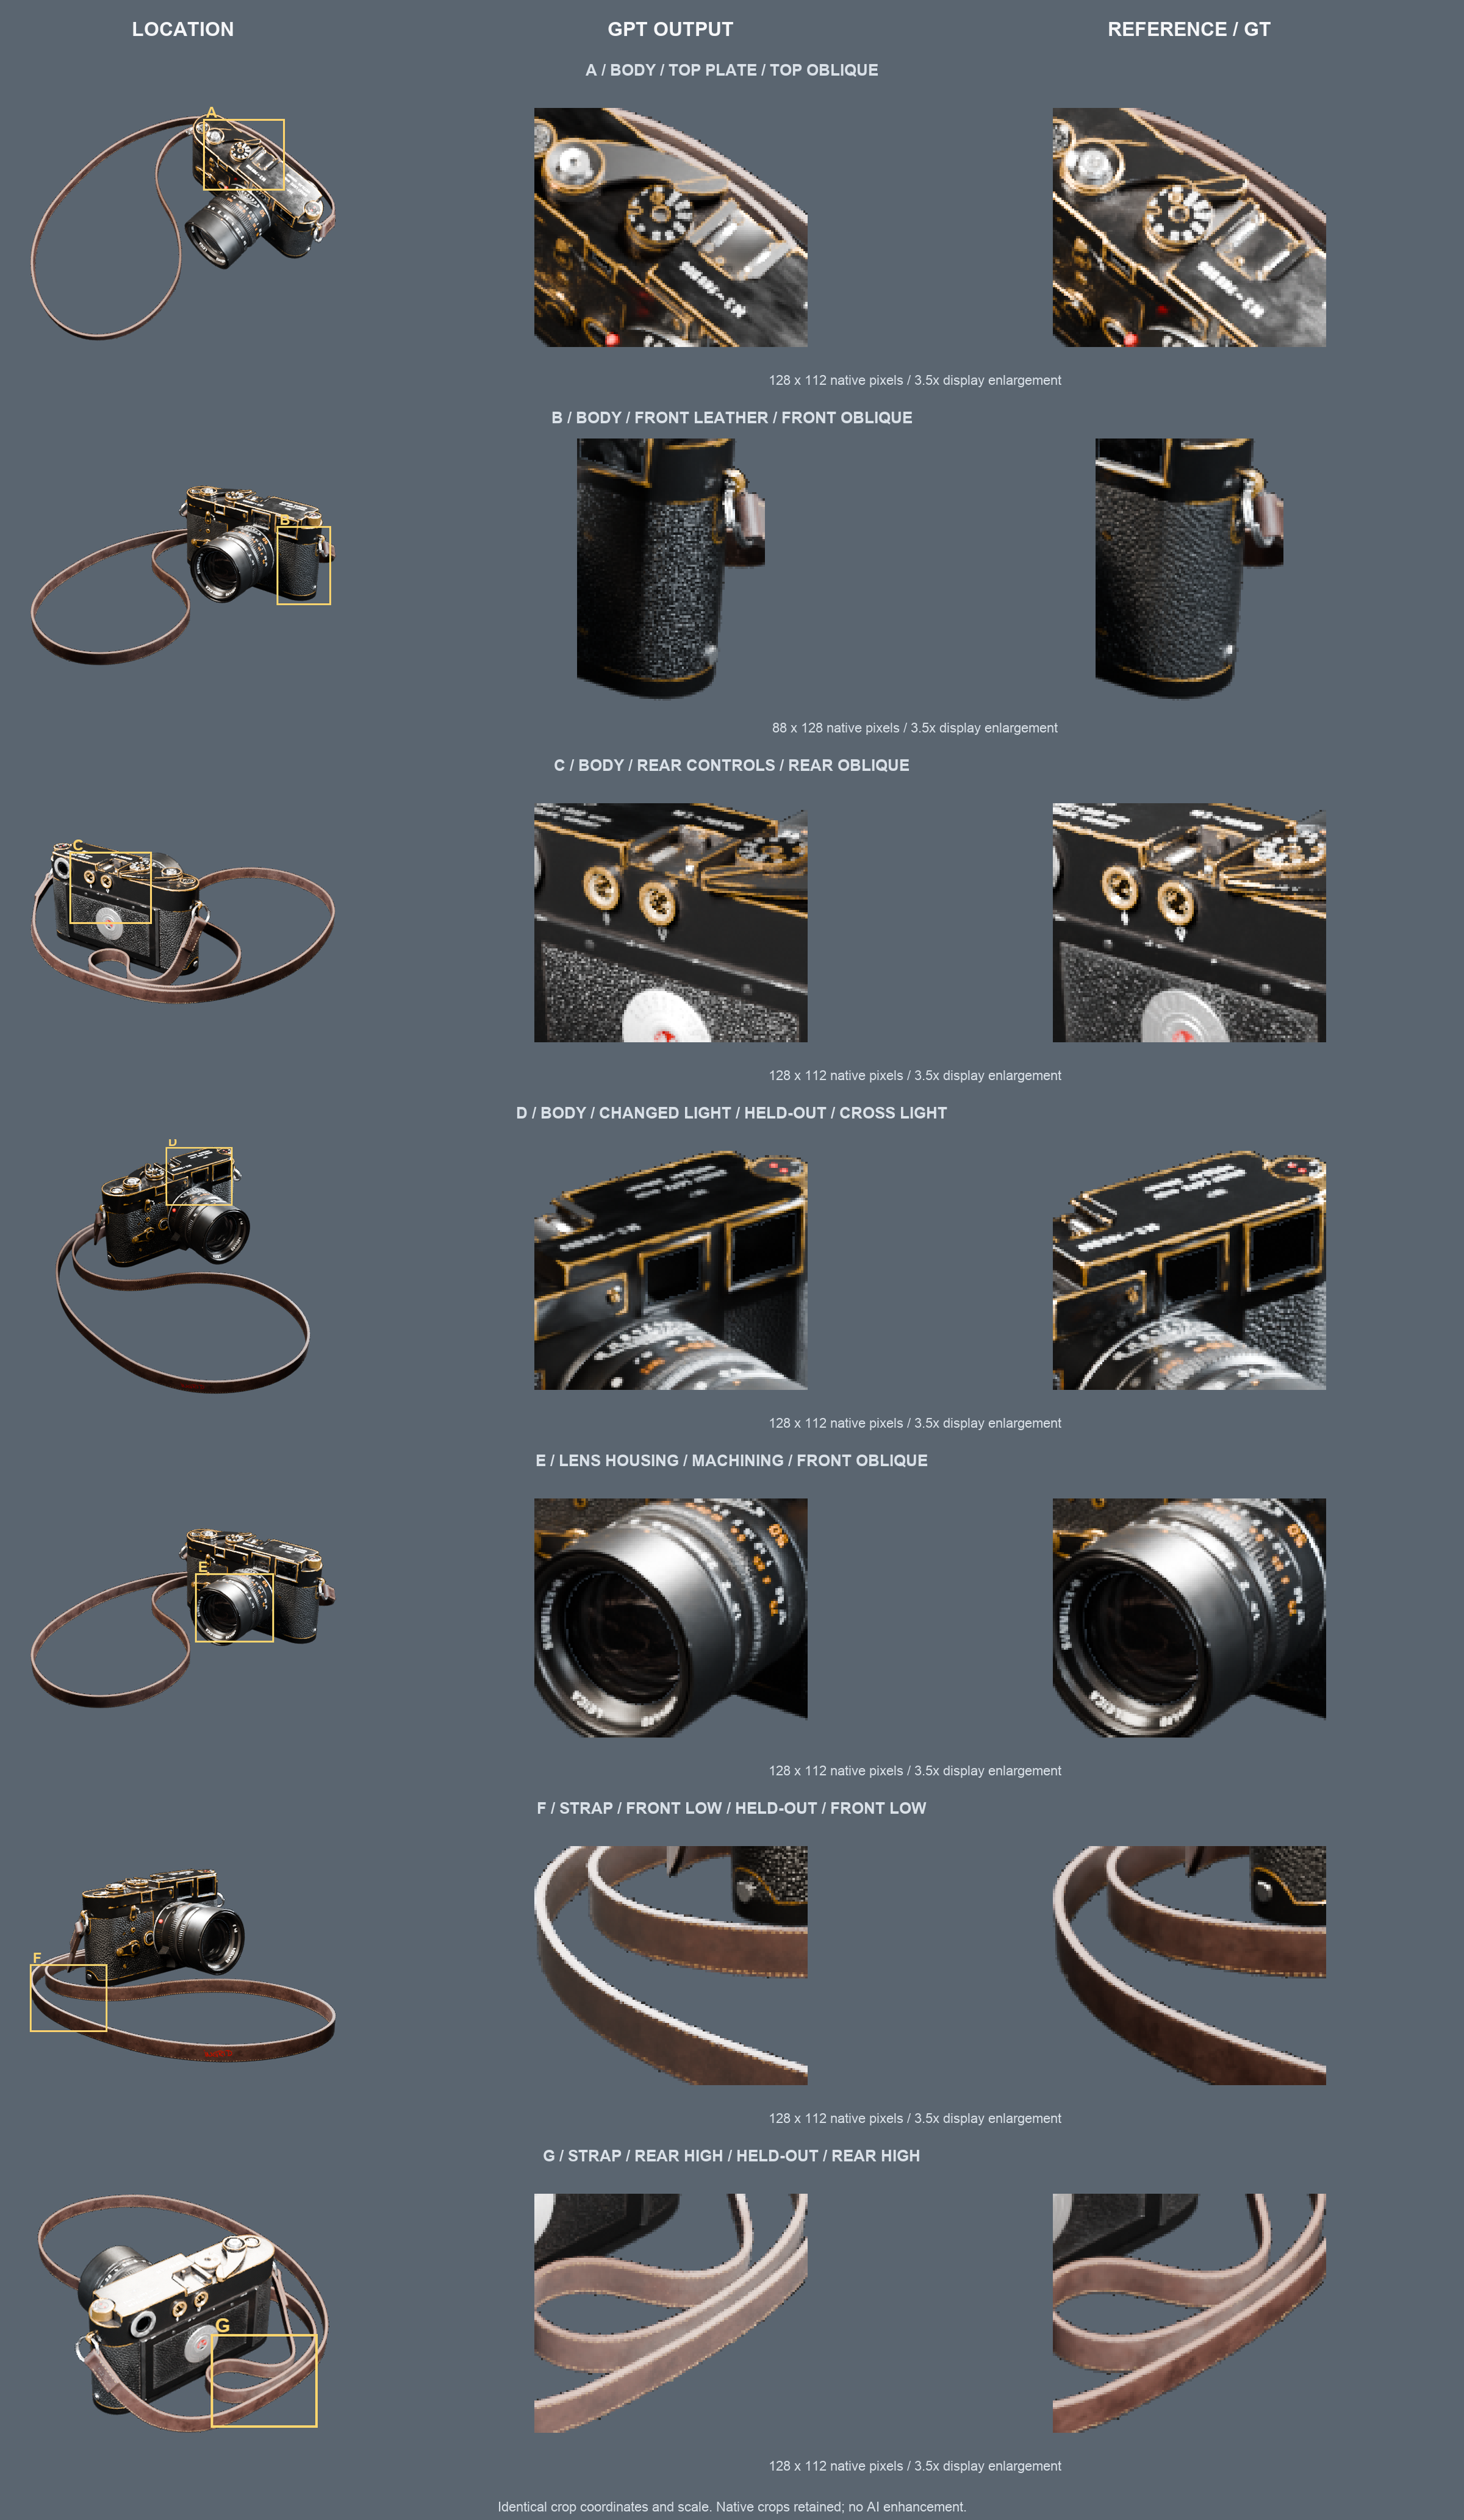
材质题是唯一预先留出视角和光照的题。在它的渲染误差表里,GPT 相对常数基线的改善在公开条件平均 7.4%,在留出条件平均只有 0.9%,前侧低视一组完全持平。
| 条件 | GPT · 目标并集 RMSE | 常数基线 RMSE | 相对改善 |
|---|---|---|---|
| 前侧 · 公开 | 0.1221 | 0.1391 | 12.2% |
| 后侧 · 公开 | 0.1142 | 0.1233 | 7.4% |
| 俯侧 · 公开 | 0.1427 | 0.1467 | 2.7% |
| 前侧低视 · 留出 | 0.1147 | 0.1147 | 0.0% |
| 后侧俯视 · 留出 | 0.1046 | 0.1050 | 0.4% |
| 交叉照明 · 留出 | 0.1146 | 0.1172 | 2.2% |
灯光和 Layout 只在公开参考相机下评测。灯光方案用了 22 盏灯、光照链接和“本地基底拟合”。如果“基底拟合”指的是逐灯渲染、再解权重去匹配参考图,那么它在这一个机位下当然接近,换个机位就未必成立,而且这样一套灯光对灯光师来说很难继续改。这一点需要读它的布光脚本确认。
3 · 六项宏观能力的证据覆盖
对照 atom_v1 主页的 U / S / X / E / D / I 框架:目前主要是 U、S、X 有证据。
| 能力 | 已有证据 | 缺口 | 状态 |
|---|---|---|---|
| U 理解与对齐 | 8 题都有“题面 → 交付” | 动画“轻快”没达成是一个反例,但没有逐条记录需求和对应证据 | 部分 |
| S 空间与约束 | MOD-03、Layout、TEX-01、灯光 | 留出视角只在材质题用过 | 较充分 |
| X 规划与执行 | 全部按时交付、可重开、编号检查点齐全 | 灯光用满 58.5 / 60 分钟,预算敏感性未知 | 较充分 |
| E 结构与可编辑性 | 材质(独立修改参数)、Layout(组件可独立移动) | 拓扑、绑定、灯光、动画都没有独立编辑测试 | 部分 |
| D 检查与诊断 | 模型都交了自查报告 | 没有把自查报告和实际缺陷对照计分 | 未测 |
| I 反馈与迭代 | — | 一个 V1 修订分支都没跑 | 未测 |
4 · 不足
按对结论可信度的影响排序。
- 几乎没有一键工具基线高
无法判断 GPT 是否超过 QuadriFlow、Smart UV 加自动打包、Rigify 加自动权重、相机投影烘焙这些现成工具。只有 Layout 有真实对照组,材质有一个带特权信息的常数基线。几个“好”的结果可能只是工具级水平。
- 灯光与 Layout 只用单一视角评测高
两题都是“参考相机 = 评测相机”,无法区分三维上合理和只对这个视角成立。材质题的数据显示,留出条件确实会改变结论。
- E / D / I 三项能力证据不足高
I 为零;D 没有计分;E 只在材质和 Layout 做了真实的独立修改。主页的六能力框架目前主要由 U / S / X 支撑。
- 人工质量评审全部是 not_assessed中
页面上的视觉判断出自写报告的人,不是盲评;与作者的对比也没有经过第三方确认。
- 各页口径不一致中
MOD-03 与 TOP-01 头部沿用 Wave-1 的运行,那时题面公开了评测方法和阈值;另外 6 题是生产需求单式题面;手部又是低提示。跨页比较不成立。
- 评测器脆弱:8 题中 4 题需要事后兼容中
UV-A 存在 Edit Mode 下读不到 UV;动画报告用了 JSON 对象被拒;人脸绑定多存了文件被白名单拒;TOP 头部旧评测在依赖检查失败。保留原判定是对的,但说明跑模型前的正负对照没有覆盖合法的格式差异。
- 测试强度偏温和中
绑定只测了抬臂、下蹲、单腿、转体和基础表情,没有举臂过头、深蹲、前臂扭转、下巴大开;TEX-01 的“不可见区域”混入了永远看不见的面,稀释了真正需要补全的区域(腋下、手臂内侧、下巴下方)。
- 每题只有 1 例、1 次运行低
符合定性阶段的设定,但结论应写成“该例”,不能写成“GPT 能 / 不能”。
- 流程覆盖:16 道工序中有 8 道没测低
缺特效模拟、正式渲染、合成、成片后期、验收 QC、交付归档,以及前期策划。其中验收 QC 最有价值:它直接对应 D 能力,
code_v05里已有 DIAG-01 / JUDGE-01 草稿。 - 报告还不适合直接外发低
大量链接显示“(未上传)”;案例页返回链接写“16 道工序主页”,主页只列 8 个;版本号一处写 v0.3,目录叫 atom_v1。
5 · 下一步
P0 全部在评测端完成,不跑模型;成本低,信息量最大。按分工,脚本由 Claude 写,执行和渲染由 codex 负责。
| 优先级 | 动作 | 回答的问题 | 谁做 | 跑模型 |
|---|---|---|---|---|
| P0 | 灯光加 2–3 台留出相机;补中性起点误差作为基线;读布光脚本确认“基底拟合”的做法 | 22 盏灯的方案是否只对一个机位成立 | Claude 写脚本,codex 渲染 | 否 |
| P0 | 每题补一个一键工具基线:QuadriFlow(拓扑)、Smart UV + 打包(UV-A,同时算作者 UV 利用率)、Rigify + 自动权重(人体绑定)、投影烘焙(TEX-01)、正弦程序步态(动画) | GPT 是否超过现成工具 | Claude 写,codex 跑 | 否 |
| P0 | 动画运动统计:从保存的动画曲线里算步幅、身体起伏、头尾转角范围、周期时长、着地占比,GPT 对作者 | 把“不轻快”变成数据 | Claude | 否 |
| P0 | 绑定极限动作:举臂过头、深蹲、前臂扭转 90°、下巴大开,两套绑定都测 | 温和动作下的“强”是否成立 | Claude 写,codex 渲染 | 否 |
| P0 | D 能力:把模型自报的检查与已发现的缺陷逐条对照(MOD-03 闭眼间隙、TOP 方框眼环、动画尾巴、材质皮纹) | 模型能否发现自己的问题 | Claude | 否 |
| P1 | 一轮 V1 反馈,同时当可编辑性测试:动画“更轻快,尾巴要摆,头随步伐动”;灯光“改成傍晚,关掉落地灯”;MOD-03 眼睑与耳朵 | I 与 E 能力 | codex | 是 |
| P1 | MOD-03、TOP-01 头部用 atom 的生产需求单题面重跑;MOD-03 test2 补跑 | 口径统一 | codex | 是 |
| P1 | 扩广度:验收 QC(DIAG / JUDGE)→ 特效模拟 → 渲染 / 合成 → 交付打包 | 流程覆盖与 D 能力 | Claude 写题,codex 跑 | 是 |
| P2 | 小规模盲评:GPT、作者、一键基线三方成对随机比较,1–2 位美术 | 进入定量阶段前的质量门槛 | 用户安排 | 否 |
6 · 核对说明
- 所有数值来自 atom_v1 各案例页(页面更新于 2026-11-07 01:10);本报告没有重跑模型、渲染器或评测器。
- 材质“相对改善” = (常数基线 − GPT) / 常数基线,用材质页“六条件显示 RGB RMSE”表中的“目标并集”两列计算。
- 动画周期:GPT 32 帧 / 24 fps = 1.33 s;作者 32 帧 / 30 fps = 1.07 s,均来自动画页。
- 动画观察:除页面上的 0 / 25 / 50 / 75% 相位图外,另从
walk_profile_comparison.mp4前 1.33 秒每 5 帧抽 1 帧复核(本页第 2 节两张帧图)。尾巴在一个周期内保持中性卷环,仅有小幅倾摆。 - 灯光“基底拟合”的具体做法是推测,需读模型的布光脚本确认;脚本在页面中显示为“(未上传)”。
- 用时:UV-A 25.85 min、TEX-01 16.39 min、材质 40 min 43 s、人体绑定 2,082 s、人脸绑定 2,176 s、Layout 1,403 s、动画 1,081 s、灯光 3,512 s(预算均为 3,600 s)。
- “16 道工序”按 atom_v1 主页流程图与案例页返回链接计数;未测工序名称取自流程图。