Wave 1 复盘与下一步策略:继续测、加难度,还是先定性?
2026-11-03 · 作者:Claude(分析与决策)· 模型:gpt-6-astra / max · 执行:codex
0. 一页结论
- Wave 1 的 V0 在工程上达到预期,在难度上没有。
- 7 个有效结果里,5 个全部通过,1 个只差 1 个面(TOP-01 test1)。
- 唯一真正失败的是 MOD-03(从两张参考图建头)。
- 在当前 L2/L3 实例上,gpt-6-astra-max 已接近天花板。BAKE 三题的着色误差甚至明显优于美术参考 B2。
- "难住 GPT"本身不是目标,"找到它的能力边界"才是。
- ZJU 那篇 CAD 论文(Zou et al., arXiv 2610.24451)不是为了难住模型:它的每个任务都有"简单 / 中等 / 复杂"三档,结果是成功和失败并存。比如零件分类 12/12,特征识别 3/6,参数化重建只有 4/11 能通过全部编辑测试。
- 它的价值来自两点:一是复杂度阶梯上的失败点;二是"满足题面列出的要求,但在题面没写的工程要求上出错"这一类发现。
- 我们现在缺的就是这两样:大多数任务族还没有爬到失败点,而且我们只检查题面写明的要求。
- 我记错的地方需要更正:并不是每个 task 都有简单版。
- v0.3 pilot(2026-10-31,16 道工序题,每题 15 分钟)可以算"全部题的简单版",当时 16 题中 14 题过了门槛,但质量被你评价为"搭积木、布线差"。
- v0.4 的 Wave 1 只保留了 MOD-01 一道 L1 对照题,其他都是 L3/L4,并且每题的 dev/test1/test2 是同一难度。
- 建议改成论文的做法:每个任务族内部设 S/M/C 三档。
- 建议的做法:"先定性、补广度,再按真实复杂度加难度",不建议直接大规模继续跑同难度的实例。
- 第 A 步:不需要新模型运行。对已有产物做定性分析,并补算"题面没写、但专业上必须满足"的指标。
- 第 B 步:还没有数据的任务族(UV-01、RIG-01、MOD-02、MOD-04B 真实改稿)各跑 1 个实例,先摸底。
- 第 C 步:给每个任务族补 C 档,复杂度只沿真实生产的维度增加,并且必须 B2 能过。
- 第 D 步:完整链(E2E)。
- 判据:某任务族的 C 档上,模型通过率 ≥ 80% 时,就把结论写成"该工序已达生产可用"并停止加码;低于 80% 时,该族就是论文的主要发现。
1. 背景与上下文
1.1 项目目标
评测通用大模型(只测 gpt-6-astra,reasoning=max,经 Codex CLI)在 Blender 中完成三维生产工序的能力。方法上对标 ZJU 的 CAD 评测论文:
- 把生产流程拆成原子能力题(拓扑、UV、烘焙、绑定、建模、改稿等),另设完整链(E2E);
- 题目和素材尽量来自真实生产,评分看"能否进生产",不看"看起来像不像"。
1.2 对标论文做了什么(Zou et al., Assessing the CAD Capabilities of General-Purpose AI Models: A Case Study of GPT-6 Astra)
- 范围:4 类 CAD 任务(理解、生成、编辑、评估),拆成 6 种测试,共 55 个主测例。全部用 GPT-6 Astra MAX + Codex,单模型案例研究,没有跨模型对比。
- 难度设计:每种测试内部都有 simple / moderate / complex 三档,复杂度因子按任务定义,例如特征相交与嵌套、视图对应、自由曲面、薄壁、装配配合、参数依赖。
- 结果是成败并存:
| 测试 | 主要结果 | 论文指出的局限 |
|---|---|---|
| 零件分类 | 12/12 正确 | 去掉候选类名并关闭联网后出现误判 |
| 特征识别 | 3/6 完全正确 | 把基体面当特征、孔分组错误 |
| 工程图 → CAD | 6/8 全部组件合法 | 3 个多件装配中只有 1 个能装上 |
| 文本 → CAD | 12/12 满足列出的要求;11/12 实体合法 | 列出要求之外的连接、传动缺失 |
| 渲染图 → CAD | 6/6 实体合法,IoU 0.879–0.992 | 曲面被平面化,圆角缺失,比例有误 |
| B-rep → 参数化 | 11/11 有建模历史;只有 4/11 通过全部 10 次尺寸编辑 | 参数依赖不完整,改尺寸后孔被封住 |
- 核心结论有四条:
- "看起来对"不等于"有效、可用、可编辑";
- 失败集中在自由曲面、参数依赖和配合关系上;
- 自主迭代修正不稳定,有时反而让误差变大;
- 用时长达数十分钟到数小时。
- 对我们的启示:
- 单模型研究的结论要靠"同一任务内的复杂度阶梯"来支撑。
- 很多失败出现在"题面没列出、但工程上默认必须满足"的要求上,论文是用事后的编辑测试和功能检查发现的。
- 编辑和迭代要单独测。
1.3 本项目的演进
| 版本 | 时间 | 内容 | 结果 |
|---|---|---|---|
| v0.3 pilot(production_v1) | 2026-10-31 | 16 道全流程工序题(PRE→PKG),每题 1 个简单实例,V0 15 分钟,跑了 V0 / V1-F / V1-S | 14/16 过门槛(另 2 题是评分器和题面问题);你看完后的评价是"搭积木、布线差",即门槛太松 |
| v0.4 重设计 | 2026-11-02 | 原子题分 L1–L4;基线 B0(一键工具)、B1(解析脚本)、B2(美术参考)、B3(Tripo);捷径审计(B0/B1 必须失败);阈值按 B2 校准;评分分门槛 / 目标 / 探针 / 人工四层 | 任务书:~/public_html/blender_bench/task/ |
| Wave 1 | 11-02 至 11-03 | 9 个任务族;冻结了 8 个实例(TOP×2、MOD-04B×1、BAKE×3、MOD-03×2);Mac 上串行跑 V0 | 见第 2 节 |
| 迁移到服务器 | 11-03 | Landlock 隔离、Blender 4.3.2、重评、V1 分支脚本 | SERVER_NEXT_STEPS.md |
v0.4 的五组"同题对照"是单模型研究的分析骨架:
- 模型与 B0/B1/B2 比;
- L1 与 L3/L4 比;
- 改自己的产物(V1-F)与改别人的资产(MOD-04)比;
- 会判断(JUDGE/DIAG)与会做(生成题)比;
- 原子题与完整链比。
如果模型在所有 L3 上都通过,第 2 组对照就失效了(L1 和 L3 都是满分),第 1 组只剩"模型 ≥ B2"。 这就是为什么必须找到失败点。
2. Wave 1 V0 结果
2.1 总表(服务器正式重评后)
| 实例 | 等级 | 判定 | 关键数值(模型 vs B2) | 用时 / 预算 |
|---|---|---|---|---|
| TOP-01 dev(Human Base 风格化头) | L3 | ✅ auto_passed | 距离 p95 0.37%(上限 0.5%,B2 0.05%);眼环 6、口环 6、可见极点 0;眨眼间隙 1.42 mm | 53 / 60 分钟 |
| TOP-01 test1(Human Base 写实头) | L3 | ⚠️ probe_failed | 全部目标通过;闭眼时 17/1650 个面翻转,上限 16.5,B2 为 0 | 52 / 60 分钟 |
| MOD-04B test2(自建设备外壳) | L4 | ✅ auto_passed | 3 处修改全对,避开了 Mirror 陷阱,修改器栈保持可编辑 | 8 / 60 分钟 |
| BAKE-01 dev(扳手) | L3 | ✅ auto_passed | 着色误差 p95 0.029,B2 0.161 | 20 / 20 分钟 |
| BAKE-01 test1(手雷) | L3 | ✅ auto_passed | 0.028 vs 0.092 | 20 / 20 分钟 |
| BAKE-01 test2(Derringer) | L3 | ✅ auto_passed | 0.026 vs 0.044 | 18 / 20 分钟 |
| MOD-03 dev(两张参考图 → 头) | L3 | ❌ goal_failed | 距离 p95 6.7%(目标 1.5%);眼角深度偏 9.7 mm;眨眼间隙 12.7 mm | 43 / 60 分钟 |
| MOD-03 test2 | L3 | — | 在 Mac 上被手动中止,需要重跑 | — |
补充说明:
- 5 个"无效提交"已改判:Mac 上 TOP×2 和 BAKE×3 被记为"无效提交",原因是提交检查器把 Blender 的 append 来源记录(LibraryWeakReference)误当成外部依赖。修复后在服务器上用同版本 Blender 4.3.2 重评原输出:模型没有重跑,输出哈希与迁移清单一致,原评分已归档。
- 基线全部失败:所有冻结实例的 B0/B1 都在门槛或目标上失败,捷径审计成立。所以模型的通过不是靠一键工具。
- TOP 用的是自写的约 320 行截面参数化重拓扑;
- BAKE 自己探测 cage 距离、修正切线空间;
- BAKE 也用了 decimate / smart UV / bake,但在其上做了大量修正。
- 成本:TOP 单次约 490 万输入 token(94% 命中缓存)、8 万输出 token;模型基本会用满预算。
2.2 MOD-03:唯一的真实失败(证据在 analysis/v0_review_20261103/)
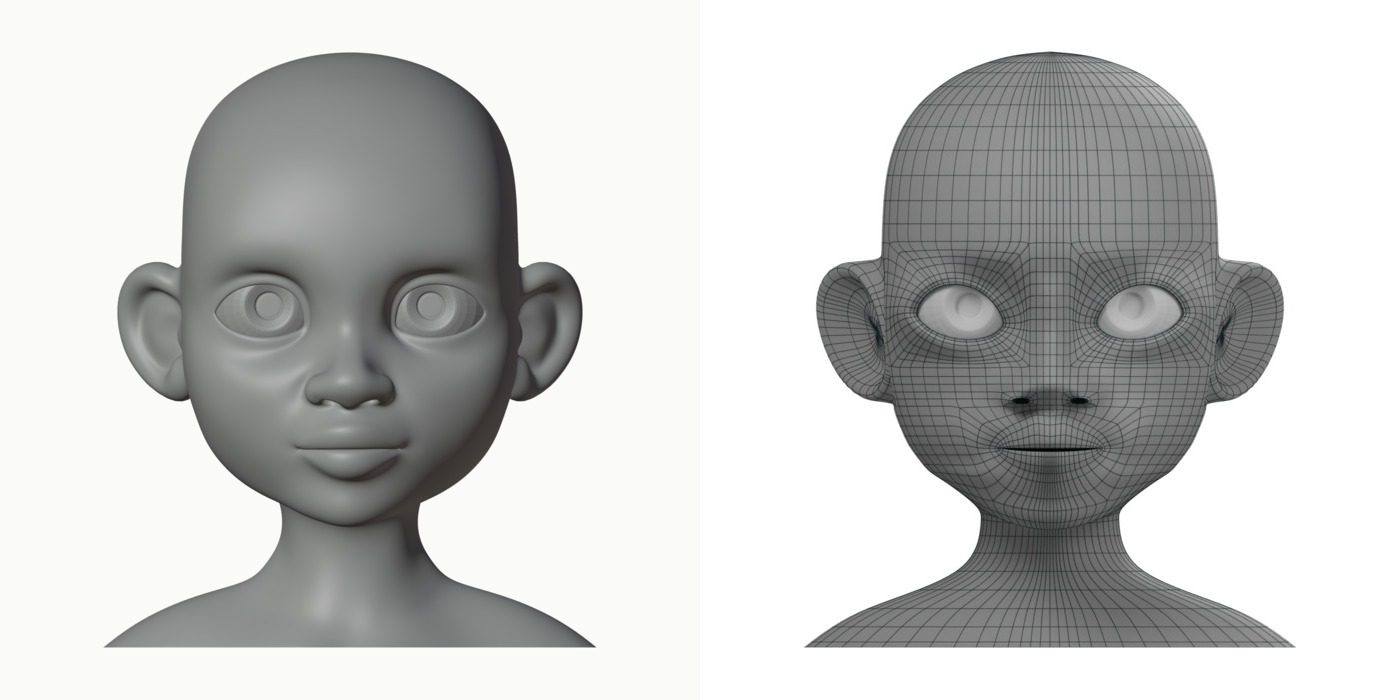
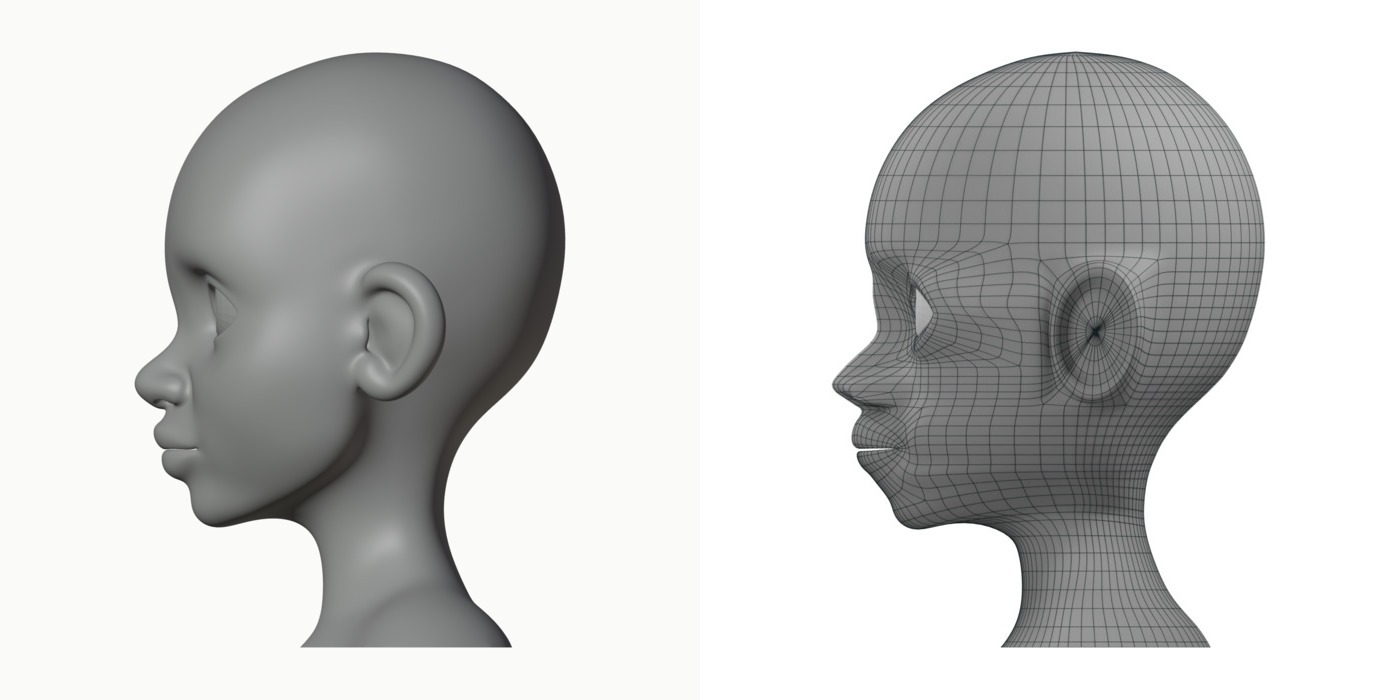
- 眼睑没有贴住眼球。
- 模型的表面经过了给定的眼角坐标(它自报误差 0.28 mm,属实);
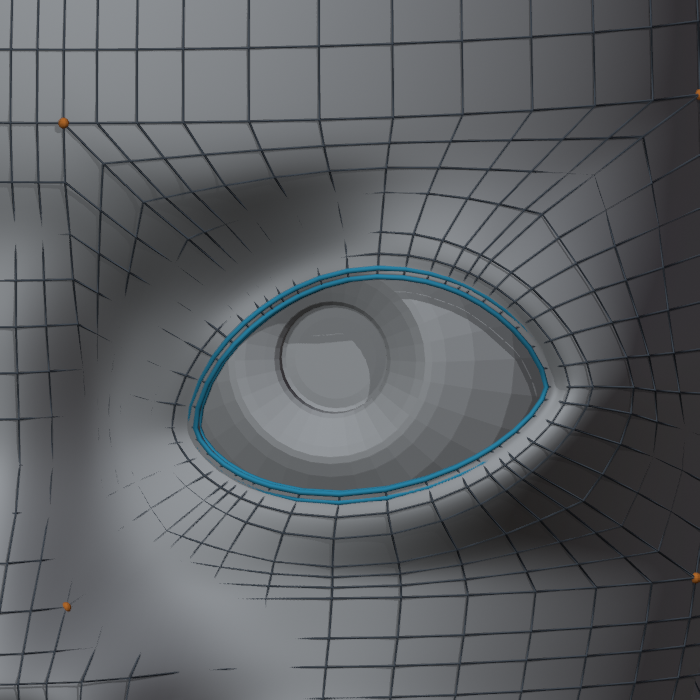
- 但眼部开口是一个往里凹的洞:开口边缘到眼球表面的距离中位数 25 mm,最近 3 mm;
- 评测器从开口边缘环测得的眼角比真实位置深 9.7 mm,评测器闭眼后还留有 12.7 mm 的间隙,约 80 个面互相穿插。
- 模型自己写的眨眼检查报告"完全覆盖",与独立评测相反,这是一条自评失真的证据。
- 侧视图和 landmarks.json 都给了眼角深度,所以这不是信息不足。
- 两张图都看不到的体积凹陷。
- 正面和侧面剪影几乎完全吻合(模型自测 IoU 0.989),但脸颊、太阳穴和耳后下颌比参考凹进 5–15 mm;
- 只看可见表面,p95 仍有 6.4%;
- 这与论文中渲染图 → CAD 的结论一致:主轮廓对了,局部几何和比例有误。
- 拓扑反而很好:每只眼 8 圈环,口环 4 圈,可见极点为 0。MOD-03 失败的是形状理解,不是布线。
- 阈值没有校准:1.5% 的距离阈值没有用"人从图片建模"的结果校准过(B2 就是源模型本身)。距离应作为连续分数报告;眼睑和眨眼的失败与这个阈值无关,单独成立。
2.3 通过的产物是否真达到"美术质量"?自动层看不出来
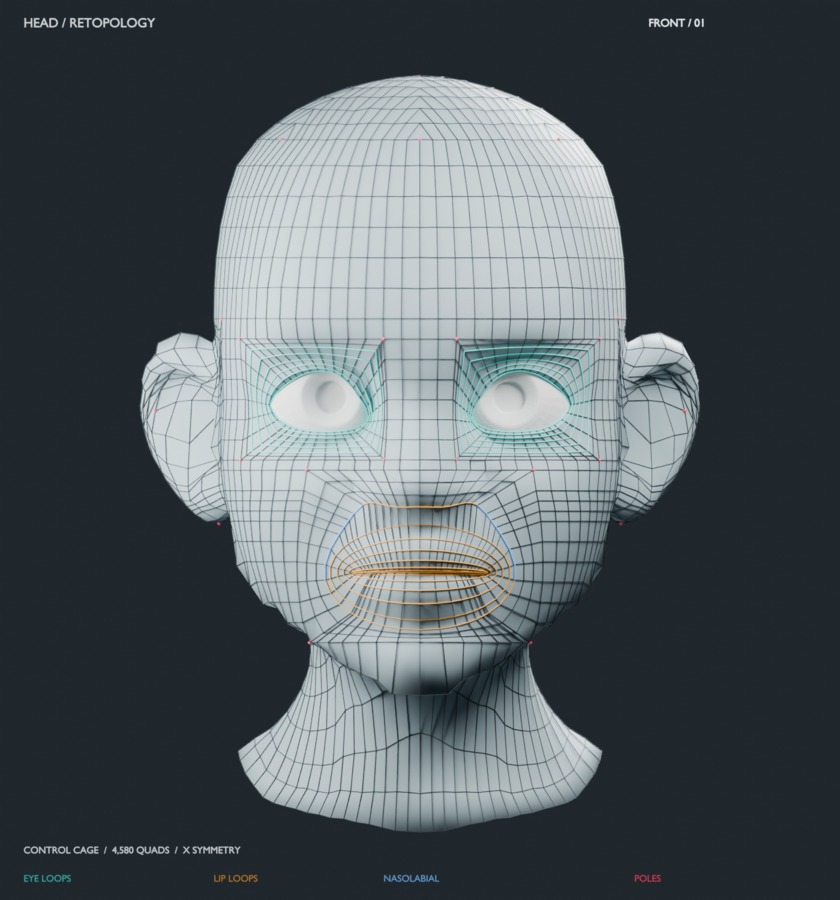
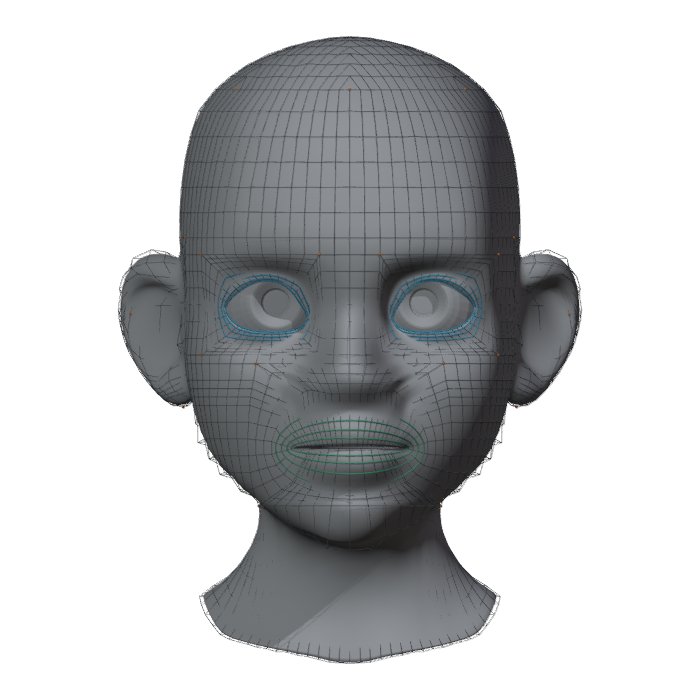
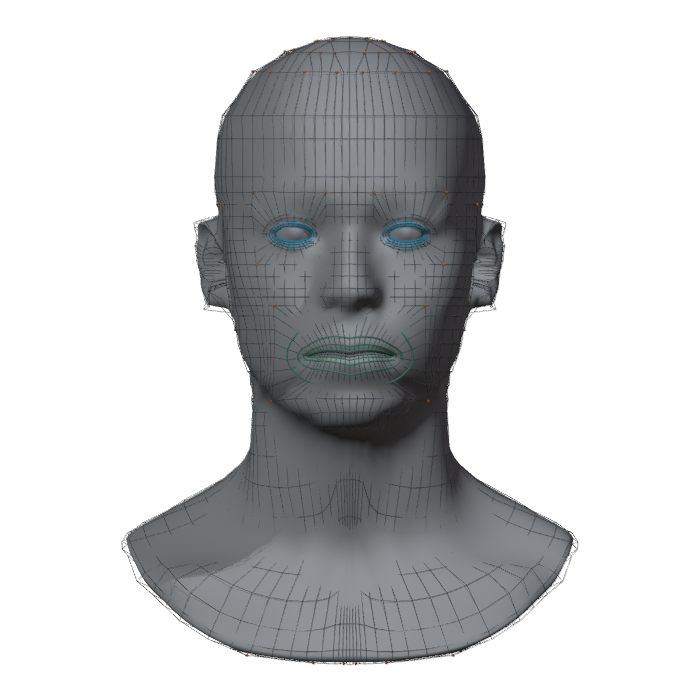
- TOP-01 dev:眼环是同心的方框,不是沿眼轮匝肌走向的椭圆;耳朵很粗糙。这些都满足题面("至少 3 圈闭合环、无可见极点"),但资深拓扑师会要求返工。
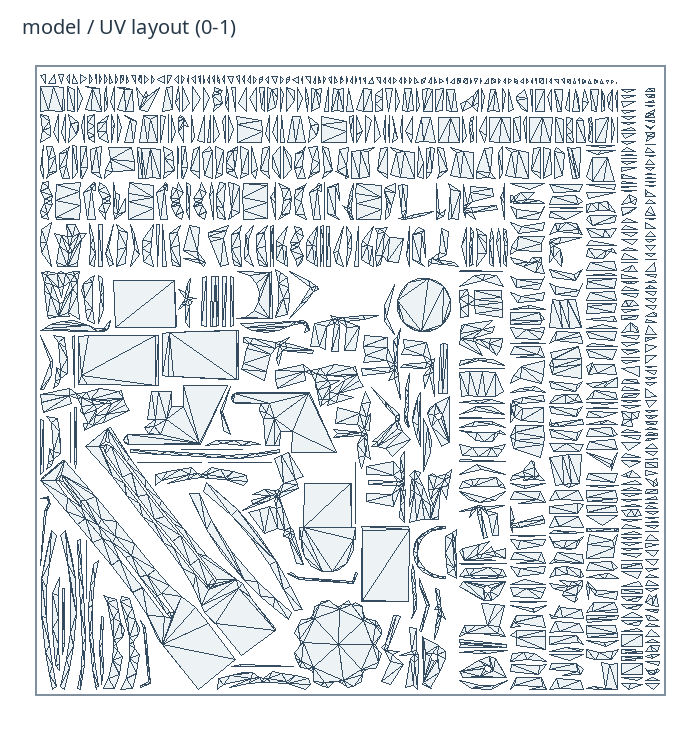
- BAKE-01 test1:硬边 367 条(B2 是 64 条),UV 被切成大量小岛。烘焙结果很准,但进引擎后顶点数会按接缝和硬边拆分而成倍增加,贴图空间也浪费。题面只要求"硬边必须在 UV 接缝上",没有限制岛数和顶点数。
- 结论:这类问题恰好就是论文说的"满足列出的要求,但不满足没列出的工程要求"。
2.4 一个贯穿全部结果的规律:题面写什么,模型就做到什么
我们的英文题面写明了评测流程和数值阈值,例如:
- "距离 p95 ≤ 包围盒对角线的 0.5%";
- "评测器会从单边选环、旋转眼睑闭眼、张嘴 15°、推嘴角"。
模型会把这些检查原样实现成自己的测试,并迭代到全部通过。轨迹里可以直接读到,例如 TOP dev:
- "surface-distance tolerance is about 2.70 mm";
- "All 19 listed loops passed Blender's selection test"。
这对工程任务是合理行为(规格本来就该写清楚),但它意味着:
- "公开规格的通过率"会系统性高估"生产可用率"。
- 能区分能力的地方只剩两类:一是规格没法完整写出的部分(MOD-03 的三维形状),二是没写出来的专业默认要求。
3. 回答你的三个问题
3.1 "之前是不是每个 task 都有一个简单任务?"
不是。准确情况是:
- v0.3 pilot:16 道工序题,每题 1 个简单实例,15 分钟,可以看作"全部任务的简单版"。门槛通过率 14/16,但你判断质量差。
- v0.4 Wave 1:只有 MOD-01(L 支架,L1) 是"简单对照",而且是跨任务的对照(用 CAD 式简单题对比自由曲面题),不是每个任务族内部的简单档。其余各题的 dev/test1/test2 是同一难度。
- 论文:在每个任务内部设 simple / moderate / complex 三档,然后报告每档的结果和用时(它的 Table III 就是按三档列平均用时)。
建议:每个任务族都改成内部 S/M/C 三档,对齐论文。
- 当前 Wave 1 的实例大多可以归为 S 或 M 档;
- v0.3 的同名题(TOP-01、UV-01、RIG-01、MOD-01)可以作为更简单的一档做定性对照。条件不同(预算 15 vs 60 分钟、评测器不同),所以不能直接算通过率。
3.2 "要对标 CAD 那篇,是不是要难住 GPT 才合理?"
需要有让它失败的实例,但"难住"必须是真实复杂度带来的结果,不能是目的本身。 理由:
- 单模型研究只有一种信息来源,就是同一模型在不同条件下的差异。 如果所有档都是满分,五组对照里大半会失效。论文能写出 limitations,靠的正是复杂档上的失败(4/11、3/6)。
- 但论文也报告了大量成功(分类 12/12、文本 → CAD 12/12),所以"这一类已经解决"本身就是有价值的结论,前提是题目足够真实、足够难,让读者信服。现在 TOP 和 BAKE 的实例偏"教科书级":干净的 Human Base 头、单件道具、预算有 10% 余量。还不足以支撑"已能进生产"这个强结论。
- 加难度的正当方式(都要求 B2 能通过):
| 方式 | 含义 | 举例 |
|---|---|---|
| 真实素材复杂度 | 生产级资产自带的复杂性 | 带口腔、鼻孔、耳道的生产头;多件、多材质、有悬浮件的硬表面;真实美术工程里的修改器栈和驱动器 |
| 真实的约束强度 | 预算不留余量 | 面数或三角数预算等于 B2 实际用量(现在是 B2 的 1.1 倍);贴图 512 px 下的 mip 安全间距 |
| 信息不完整 | 输入像真实工作那样不全 | MOD-03 式只给部分视图;概念图不是正交投影;尺寸不全 |
| 未写明的专业要求 | 不写进题面,但美术默认会做到 | 环的形状和走向、引擎顶点数、UV 岛数、没要求的表情变形、非几何数据保持;必须 B2 通过、B0/B1 失败,事后用独立检查发现,即论文的方法 |
| 修改与迭代 | 改别人的资产、改自己的产物 | 改别人的资产(MOD-04B 真实工程);对已通过的 V0 发改稿单(LOD、加深 logo、降面数),检查改动合规和未改动部分是否保持,对应论文的"编辑测试" |
| 长链路 | 工序之间误差累积 | E2E 链 |
- 不正当的加难方式(要避免):
- 故意含糊或自相矛盾的题面;
- B2 也过不了的阈值;
- 只为卡模型而设、和生产无关的检查;
- 看到模型结果后再收紧已冻结的阈值。
- 建议的目标区间:每个任务族的 C 档在 B2 通过的前提下,模型通过率落在 20–70% 最有信息量。高于 80% 就写"已解决",低于 20% 要先排查评测器和题面问题。
3.3 "继续测试,还是先增加难度,还是先定性?"
| 选项 | 内容 | 信息量 | 成本 | 评价 |
|---|---|---|---|---|
| ① 继续按原计划跑同难度实例 | TOP test2、BAKE 更多实例等 | 低:预期大概率通过 | 每个 L3 实例约 1–1.5 小时模型时间 | 只在需要"3 个实例都通过"来支撑"已解决"时才值得 |
| ② 先定性(不新跑模型) | 对已有产物做人工盲评(模型 vs B2)、补算未写明的专业指标、自评 vs 实测、轨迹分析 | 高:决定往哪里加难度 | 约 1 天,只需评测端计算和人工 | 立刻做 |
| ③ 补广度(同难度,未测的任务族) | UV-01、RIG-01、MOD-02、MOD-04B(G502)各 1 个实例 | 高:这几族可能本来就会失败 | 需先完成资格准备,各约 1 小时模型时间 | 紧接着做 |
| ④ 加难度(C 档) | 按 3.2 的方式补 C 档 | 最高:找到边界 | 每族准备约 1–2 天,加上模型时间 | 在 ②③ 之后定向做,避免盲目加码 |
| ⑤ 完整链 | E2E | 高,但归因难 | 每条约 3 小时 | 原子题边界清楚后再做 |
建议顺序:② → ③ → ④ → ⑤;① 只在补齐"已解决"结论时少量做。 已经排进队列的 MOD-03 test2 重跑,以及 MOD-03 dev / TOP-01 test1 的 V1,照常跑,成本低,而且直接对应"迭代修正"这个论文维度。
4. 具体执行计划
第 A 步:定性与回溯(不需要新模型运行;Claude 写代码,codex 跑和渲染)
- 未写明的专业指标:对所有 V0、B2、B0/B1 产物补算(只记录,不改已冻结判定):
- TOP/MOD-03:
- 眼环和口环的椭圆拟合残差(圆度)、相邻环间距是否均匀;
- 边流与主曲率方向的夹角;
- 极点总数和面尺寸均匀度与 B2 的比值;
- 未公开的表情探针(抬眉、嘟嘴、眯眼);
- 眼睑开口到眼球的距离(本文 2.2 已手算一例)。
- BAKE:
- 引擎顶点数(按 UV 接缝和硬边拆分后)与 B2 的比值;
- UV 岛数、UV 利用率;
- 512 px 下的 mip 间距;
- 法线图在 UV 接缝处的跳变。
- MOD-04B:UV、顶点组、自定义法线、材质槽、命名等非几何数据是否保持;修改是否只影响局部。
- 每项先在 B2 上校准:B2 必须通过,B0/B1 应失败,否则不采用。
- TOP/MOD-03:
- 人工盲评(对应任务书里的"人工层"):
- TOP dev/test1、BAKE ×3 各做一组"模型 vs B2"匿名配对;
- 请 1–2 位懂拓扑或游戏资产的人按 0–4 分评"能否直接进生产";
- 这是判断"自动通过 = 美术通过?"的唯一直接证据。
- 自评 vs 实测:逐题对比 report.json 的自述与评测结果(MOD-03 已有一例:自测眨眼通过,实测间隙 12.7 mm),对应论文"评估"维度。
- 轨迹分析:从 events.jsonl 统计时间分配(建模 / 自检 / 渲染)、迭代次数,以及哪些检查是模型自己设计的、哪些是照搬题面的。
第 B 步:补广度(每族 1 个实例,同等难度)
依次为 UV-01(ST-rain 或 ST-victoria)、RIG-01(ST-snow)、MOD-04B(G502 真实改稿)、MOD-02(先确认 m510 被拒的原因是合同过严还是 B2 选错),以及 MOD-03 的第三个实例 Ellie。完成资格审计后各跑 V0。
第 C 步:每族建 S/M/C 阶梯(每族至少 1 个 C 档,在第 A/B 步的发现之后定)
| 任务族 | S(已有或简单) | M | C(加难方向) |
|---|---|---|---|
| TOP-01 | HB 风格化头(已过) | HB 写实头(边缘) | 生产头(ST-rex / Q-UBC),带口腔、鼻孔、耳;预算等于 B2;加入未写明的环形状和表情探针 |
| MOD-03 | 增加信息:再给 3/4 视图、背面、顶视图 | 正面 + 侧面(现状,已失败) | 非正交的概念图;风格化与写实各一 |
| BAKE-01 | 扳手(已过) | 手雷、Derringer(已过) | 多件、多材质、带悬浮件;三角预算等于 B2;加入引擎顶点数和 UV 岛数检查;附 LOD1 改稿单 |
| MOD-04B | 自建外壳(已过,8 分钟) | G502 改稿 | Bose QC15(复杂修改器栈、下游依赖) |
| UV-01 / RIG-01 / MOD-02 | 等第 B 步结果再定档 |
MOD-03 的阶梯是往简单方向补:它在 M 档就失败了,增加视图可以回答"瓶颈是信息不足,还是三维形状理解"。
第 D 步:完整链(Wave 2)
在原子题边界清楚后再做,用来回答"误差在哪道工序累积"。
已通过实例的 V1-F
现有的改稿模板(BAKE 降到 958 三角形、MOD-04B 加深 logo 并在另一侧加凹槽、TOP 加环)需要先补评测代码,以检查改动合规和未改动部分保持。补完再跑。这一项直接对应论文的"可编辑性"测试,是已通过实例上最便宜的加难方式。
5. 报告的组织方式(对齐论文)
- Table I:任务族 × 输入/输出 × 复杂度因子 × 实例数(S/M/C)。
- Table II:主要结果 + 局限。分三列:"题面要求通过率"、"未写明的专业要求通过率"、"人工评分"。
- Table III:按 S/M/C 列平均用时。
- 跨任务分析按论文的 5 条组织:
- 能做什么;
- 题面通过但专业不合格;
- 改稿和编辑;
- 自评和迭代;
- 用时。
- 每个失败都要先排除评测器和题面问题,再归因到模型。v0.3 的 MOD-01 孔径误报、Wave 1 的依赖检查误报都是教训。
6. 需要你拍板的事项
- 同意"② → ③ → ④ → ⑤"的顺序吗? 同意的话,第 A 步的代码由我来写(专业指标、改稿评测),codex 负责跑和渲染。
- 人工盲评找谁? 至少需要 1 位懂拓扑或游戏资产的评审,每组约 10 分钟。
- 要不要改变题面的公开程度? 建议:
- 已冻结实例不动;
- 新的 C 档把要求分为"题面要求"(公开)和"专业要求"(不公开,但必须是 B2 通过、业内默认的标准),两者分别报告;
- 这是本项目与论文对齐的关键设计选择,需要你确认。
- "已解决"的判据:C 档通过率 ≥ 80%,且人工评分不低于 B2 减 1 分,是否认可?