0 · 一页结论
TOP-01 的“自动通过”是评测器的假通过
人工对比美术参考,GPT 的面部布线不合格:
- 眼周是方框;
- 嘴是嵌进去的补丁;
- 鼻子是网格上挖洞;
- 面颊只有横竖线。
原因写在它的建模脚本里:先建圆柱状规则网格,再挖矩形洞、补同心圆环。我们的检查只看环的个数、小范围内有没有极点、贴合误差和几个公开的简单变形,这些是必要条件,不是充分条件。报告里不能把 TOP-01 写成“通过”。
- 重拓扑在工业里不只针对头部。值得测的是动画角色的重拓扑:头部、身体关节、手部,以及没有模板的生物和 Boss。这些工作靠人工,自动工具达不到专业标准。
- 硬表面(高达、枪械、载具)的游戏低模已经由 BAKE-01 覆盖;
- 建筑、场景、扫描件基本已经自动化,不值得拿来测 GPT。
- 头部不简单。脸是有机重拓扑里最难、审查最严的部分。我们的实例确实简化了(输入干净、给了地标、规则写进题面),但 GPT 在这个最简化的头上已经不合格,所以缺的是能识别布线好坏的评测,不是更难的几何。
- 后续计划:重拓扑做三项——TOP-A 头部、TOP-B 身体关节、TOP-C 手部,分别考面部表情、大关节旋转和密集小关节三种变形。每项 2 个实例(风格化和写实各一)。先改评测,再起实验,否则会重复假通过。
- 这三项作为重拓扑的核心已经够用。生物/Boss、服装、标准拓扑包裹都可以以后再加;硬表面放在 BAKE 里。
- 一题有好几个实例,有两种不同的目的:
- 同难度的重复(dev/test),用来调试评测,并判断一个现象是偶然还是系统性的;
- 有意改变某个因素的不同情况(头、身体、手;简单、中等、复杂),每个可能暴露不同问题。
1 · Wave 1 TOP-01 的实际问题
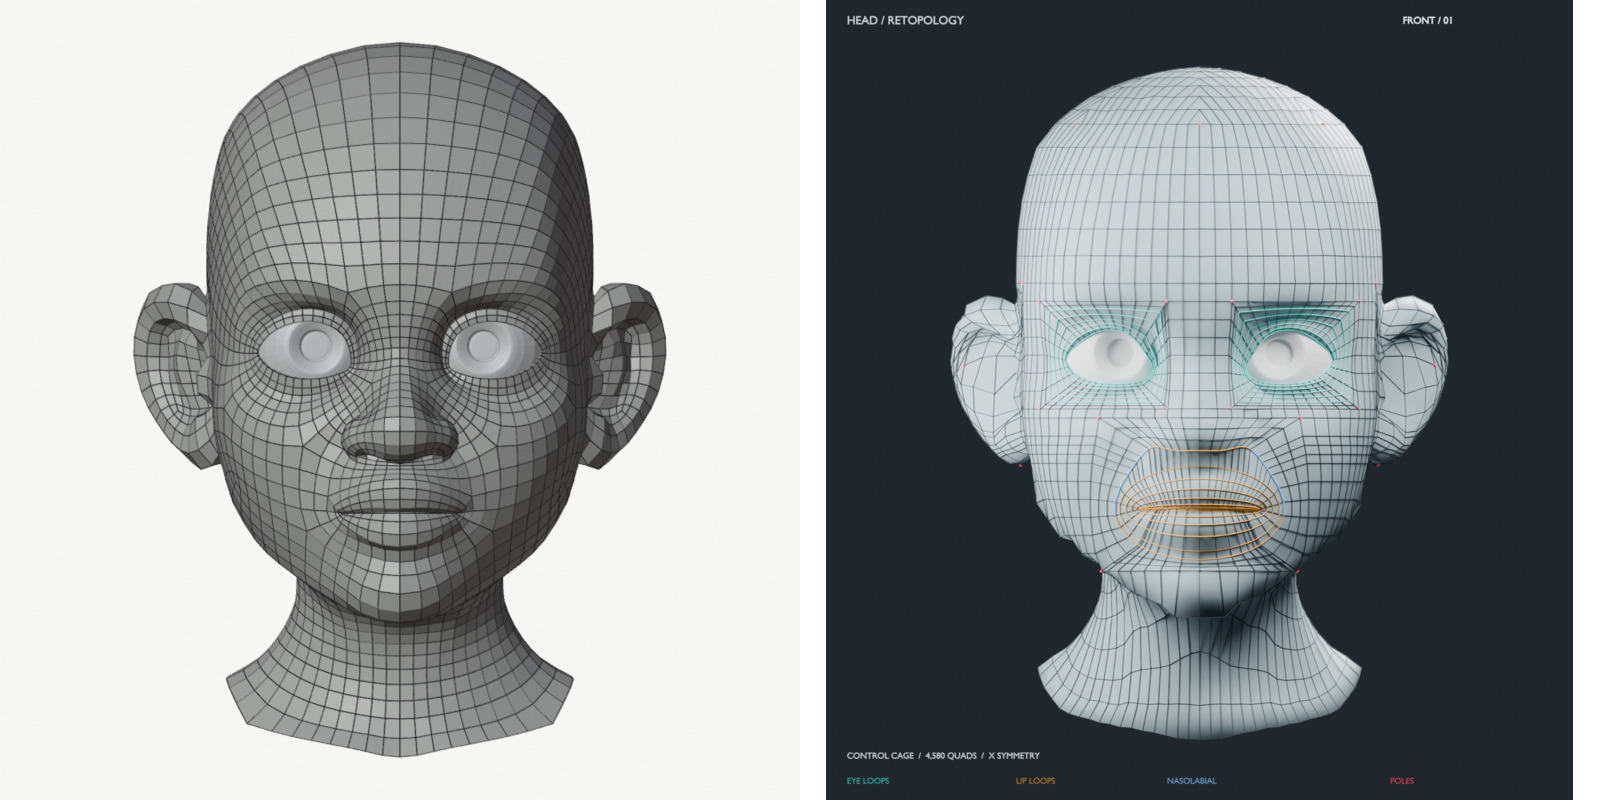
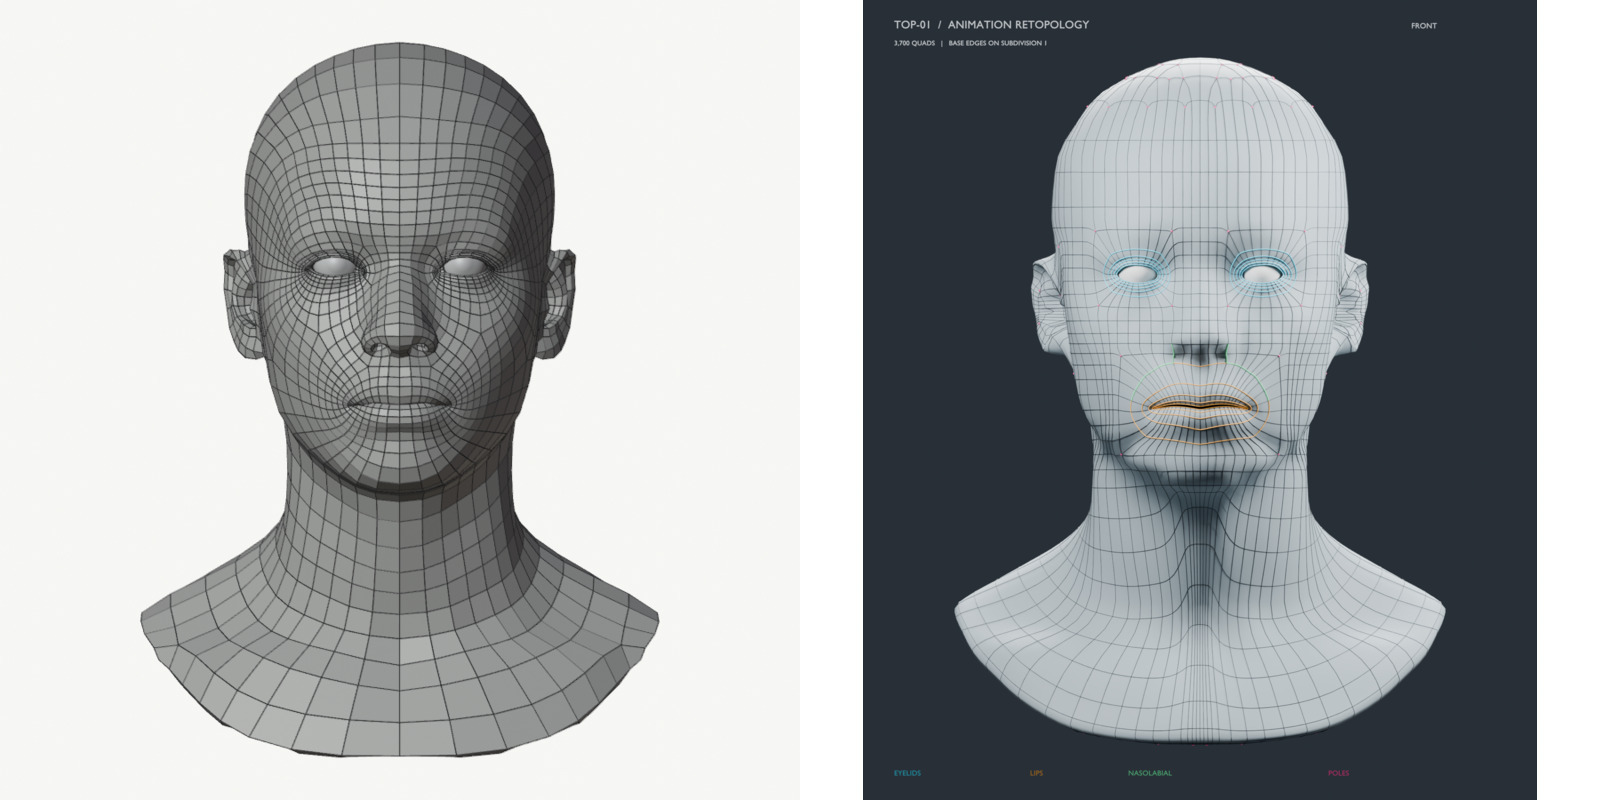
| 区域 | 美术参考的做法 | GPT 的做法 |
|---|---|---|
| 眼周 | 眼环从眼睑一圈圈放射,逐渐融进眉弓、鼻梁和颧骨 | 内圈绕眼,往外很快变成方框,四个角各有一个极点,框外直接接横竖网格(dev 最明显) |
| 嘴周 | 口环向外延伸,接进鼻唇沟和下巴 | 椭圆补丁嵌进网格,四周没有过渡 |
| 鼻子 | 鼻翼、鼻孔周围有环形结构,鼻梁有走向 | test1 是网格上挖两个洞,正面发黑 |
| 面颊 | 沿颧骨和鼻唇沟转向 | 横线竖线 |
| 其他 | — | 耳朵粗糙;test1 脖子正面的竖线向中间挤 |
原因:构造方法决定了方框
test1 的 build_retopo.py 先按固定高度和角度建一个圆柱状规则网格,然后:
# Rectangular chart holes; regular annuli replace their interiors.
holes=[('Eye_L',3,10,eye_i0,eye_i1),('Eye_R',N-10,N-3,eye_i0,eye_i1),('Mouth',-8,8,mouth_i0,mouth_i1)]
也就是在网格上挖矩形洞,用同心圆环补进去。圆环最外圈必须对上矩形洞的边,所以眼环和嘴环从里到外必然从椭圆变成方框。这是“搭积木”在拓扑上的表现:先满足规格,而不是先设计边流。
评测器为什么判它通过
| 现有检查 | GPT 结果 | 漏掉了什么 |
|---|---|---|
| 眼周 ≥ 3 圈、嘴周 ≥ 2–3 圈同心闭合环 | 通过(6 / 6) | 方框也能被数成“闭合同心环”;不看形状和走向 |
| 眼睑和嘴唇小范围内的可见极点 | 0 个 | 方框四角的极点在检查范围外;不看极点整体放在哪里 |
| 表面贴合(距离 p95) | 0.37%(上限 0.5%) | 与布线无关 |
| 旋转闭眼、张嘴 15°、推嘴角 | 通过(test1 差 1 个面) | 变形太简单,暴露不出边流问题;而且这些探针写进了题面,模型照着自测 |
| — | — | 没有检查:边流方向、结构线(鼻唇沟、眶缘、下颌线)、密度分布、耳朵、未公开的表情 |
题面还把这些检查和阈值原样告诉了模型(task_contract.json 里也有一份),模型就精确地满足了这些检查。这与 CAD 论文的结论是同一类:满足题面列出的要求,不满足工程上默认的要求。
2 · 重拓扑在工业里的全貌
判断一类资产值不值得拿来测 GPT,要同时满足两条:工具达不到专业标准,并且人在这上面花大量工夫。只要一键工具就能做到,测 GPT 的意义就不大。
| 资产类型 | 重拓扑是为了什么 | 关键要求 | 自动工具现状 | 人工量 | 测 GPT 的意义 |
|---|---|---|---|---|---|
| 角色脸 / 头(动画) | 表情绑定、形态键 | 边流沿面部结构走;眼、嘴、鼻唇沟的环;极点放在变形小的地方 | ZRemesher、QuadriFlow 只能出均匀四边面,出不了这些环;大工作室常把标准拓扑包裹到新雕刻上,再人工修 | 主角头几小时到一两天 | 高 |
| 角色全身 | 骨骼蒙皮 | 肩、肘、膝、髋的环线;手指关节;衣服 | 自动工具在关节处不达标 | 主角全身通常数天 | 高 |
| 生物 / Boss | 非人体结构变形(翅膀、尾巴、触手、多肢) | 没有标准模板,每个都要从头设计 | 基本靠人工 | 很大 | 高,最考“设计” |
| 硬表面·游戏(枪械、载具、高达零件) | 低模 + 烘焙 | 剪影、硬边与 UV 接缝、三角面预算 | 自动减面在硬边和着色上不行;LOD1 以后可以自动生成,主资产的 LOD0 多半手做 | 零件多、总量大,单个零件不难 | 中,就是 BAKE-01 |
| 硬表面·影视(机甲、产品 SubD) | 可细分的干净笼子 | 支撑环、曲面上的极点、布尔运算后的清理 | Quad Remesher 加硬边识别能做一部分 | 中 | 中,接近 MOD-02 |
| 建筑 / 场景 / 扫描 | 减面、LOD、实时渲染 | 面数和外观 | 基本自动化(Simplygon、InstaLOD、扫描后处理),或直接用模块化低模搭 | 少 | 低 |
- Wave 1 的手臂变体因为“QuadriFlow 能通过”被删掉了。现在看,原因是手臂检查只数了肘部有几圈环,太弱,并不说明自动工具已经达到动画标准。
- 头部这边是另一头的错:同样弱的检查让 GPT“通过”了。
3 · 头部会不会太简单
- 在工业里,脸恰恰是有机重拓扑最难、审查最严的部分。眼睑厚度、内眼角、嘴角汇聚、鼻孔、耳朵、口腔袋都集中在这里,而且要支持几十到上百个表情形态键。
- 我们的实例被简化了:
- dev 的输入是美术网格细分后得到的光滑表面,没有雕刻细节;
- 给了地标点;
- 规则和检查流程都写进了题面。
- 但 GPT 在这个最简化的头上已经不合格。所以 TOP-A 现在缺的不是更难的几何,而是能识别“布线不对”的评测。头部要保留,先把衡量方法修好;等评测可靠了,再考虑换成带口腔、鼻孔的生产级头作为更难的实例。
4 · 后续计划:重拓扑三项
三项分别对应三种不同的变形驱动,素材都来自已下载的 Human Base Meshes(美术网格可以直接作 B2)。每项 V0 60 分钟。顺序是先改评测,再起实验。
TOP-A · 动画头部
L3评测待改从雕刻高模做出能给面部绑定和表情形态键用的头部低模笼。
Sculpt、两个眼球、地标点(与 Wave 1 相同)Retopo 网格(四边面为主、对称、带细分),线框图,拓扑说明,自检报告TOP-B · 身体关节
L3需准备身体(去掉头和手)的重拓扑,重点考大关节在大角度旋转下的布线。
Retopo,线框图,拓扑说明,自检报告GEO-body_male_stylized;test:GEO-body_male_realistic。不用女性身体:MOD-03 用女性身体切出来的头作隐藏参考,再用会泄漏- 关节环:关节处的环是否垂直于骨骼方向,环数是否足够。代码里已有
topo.joint_loops。 - 评测端蒙皮:用
rig.Skin按固定骨架和权重,把模型和 B2 摆成同样的姿势(抬臂 150°、屈肘 140°、屈膝 120°、屈髋 90°、手腕扭转 90°),比较体积损失、褶皱处穿插和扭曲,阈值相对 B2 定。 - 其他:极点位置、边方向与 B2 对齐。
TOP-C · 手部
L3需准备手的重拓扑:狭小空间里有大量小关节。
Retopo,线框图,拓扑说明,自检报告Hand - Stylized(880 面);test:Hand - Realistic(820 面,带 Multires 细节)。都是 Human Base 包里独立的手,没有用在其他题tools/landmarks.py)5 · 评测怎么改
工业里没有通用的数值阈值,实际靠资深美术看线框,再加表情和姿势测试。可以计算的代理指标如下。每项都先在 B2 上校准:B2 应该过,QuadriFlow 等基线应该不过。
| 指标 | 怎么算 | 抓什么问题 | 成本 |
|---|---|---|---|
| 环的方框度 | 沿每条眼环、口环、关节环计算转角分布:方框形的环转角集中在 4 个约 90° 的角上,美术的环转得平滑 | 正是这次看到的方框问题 | 低 |
| 边方向与 B2 对齐 | 在同一表面位置比较模型和 B2 的边方向,角度差按 90° 取模,按区域统计 | 面颊、肩部横竖网格不顺结构 | 中:需要多个美术参考来定容差,否则会误伤另一种合理的布线方案 |
| 结构线覆盖 | 在 B2 上标一次鼻唇沟、眶缘、下颌线、肘窝等结构线,检查模型在附近有没有顺着走的连续边 | 只连了两端,中间没有顺着走 | 中 |
| 表情 / 姿势测试 | 用与拓扑无关的位移场或评测端蒙皮,做微笑、抬眉、眯眼、握拳、屈肘等;看细分后褶皱能否顺着线形成,还是变成锯齿 | 静态好看、一动就坏 | 高,但最接近真实验收 |
| 人工两两盲评 | 模型 vs B2 匿名配对,按 0–4 分评“能否直接进生产” | 最终依据 | 需要 1–2 位懂拓扑的评审 |
题面公开程度也要定。一个干净的对照是:同一素材、同一评测器,只改题面——
- 版本一:完整规格(现状,规则和检查流程都写明);
- 版本二:只给工业需求单(例如“给 FACS 面部绑定用的动画头,面数不超过 N”)。
两者的差距就是“会做”与“知道该做什么”之间的差距。task_contract.json 里的阈值也应该去掉,只留交付物名称和预算。
学术上直接相关的研究:Animation-Aware Quadrangulation(SGP 2013)用动画变形的主方向来指导四边形方向;2018 年的一篇论文用多姿态的变形度量来调整方向、密度和长宽比。链接见文末。
6 · 重拓扑这样够不够
作为核心,头部 + 身体关节 + 手部已经够用。它们覆盖了人形角色的三种变形驱动:面部表情、大关节旋转、密集小关节。
| 没覆盖的 | 是否需要 | 放在哪 |
|---|---|---|
| 生物 / Boss(非人体结构,无模板) | 可选,最考“设计” | 三项做完后,如果结果有好有坏,再加一个 |
| 硬表面低模(高达、枪械) | 需要 | 已在 BAKE-01;机甲零件可以做它的更难实例 |
| 标准拓扑包裹(工业常见做法) | 可选 | 是另一种题型,暂缓 |
| 服装、游戏三角面预算版 | 暂不需要 | — |
| 建筑 / 扫描减面 | 不需要 | 工具已经能做 |
三项做完、评测可信之后,就可以转到其他 task。
7 · 为什么一题有好几个实例
有两种不同的目的,需要分开看:
① 同难度的重复(dev / test1 / test2)
- dev:用来调试题面和评测,可以看、可以改,不进最终结果;test:冻结后跑,用来报告。
- 判断偶然还是系统性:只有一个样本时,通过或失败可能是运气或素材的特殊性。比如 TOP-01 的 dev 和 test1 都出现方框布线,就说明这是它的方法本身的问题。
- 避免把评测和题面调成只适合某一个素材。
② 有意改变某个因素(不同情况)
- 头、身体、手;风格化、写实;简单、中等、复杂。每个可能暴露不同问题。
- 你说的“测不同的情况、反映不同的问题”就是这一种。CAD 论文每种测试里的 simple / moderate / complex 也是这一种。
- 设计时要写清楚:这个实例在改变哪个因素,预期暴露什么问题。
还有第三种:同一实例重复跑,用来看模型每次结果的波动。模型是随机的,成本允许时可以对关键实例跑 2 次。
样本量方面要诚实:每题只有 2–3 个实例,只能写成案例研究(CAD 论文每种测试也只有 6–12 个),不能写成“通过率 xx%”这种统计结论。
8 · 待决定与待办
| # | 事项 | 建议 |
|---|---|---|
| 1 | TOP-01 test1 的 V1 还没跑。之前写的 V1-F 反馈只针对“闭眼多翻 1 个面”,现在看已经不对 | 先不跑。等评测改好以后,改成真正的主美反馈(眼周方框、嘴是补丁、鼻子是网格)再跑,测它能不能按边流反馈修改 |
| 2 | upload/top01-edge-flow-20261104/ 和本页的对比图含 TOP-01 的 B2(隐藏答案),而 test1 的 V1 还没跑 | 风险很低(模型禁用网页搜索,也不知道网址),但可以在相关运行结束前收紧目录权限 |
| 3 | 题面公开程度 | 新实例采用“只给需求单”的版本,或者两个版本都跑做对照(第 5 节) |
| 4 | 人工盲评找谁 | 至少 1 位懂拓扑的评审,每组约 10 分钟 |
| 5 | 预算是否给 B2 面数 10% 的余量 | 新实例建议不留余量,或在题面写明“预算 = 美术参考的面数” |
执行顺序:写新指标 → 用 TOP-A 现有的 V0 产物、B2 和基线校准 → 准备 TOP-B / TOP-C(地标、出题、捷径审计)→ 冻结后起实验。
参考资料
- Zou et al., Assessing the CAD Capabilities of General-Purpose AI Models: A Case Study of GPT-6 Astra, arXiv 2610.24451。
- Autodesk:Modeling the Head(面部边流、眼周环线、极点位置)。
- Maxon ZBrush:Retopology(动画角色需要特定的环线模式)。
- Blender Studio:Planning the Facial Retopology。
- Animation-Aware Quadrangulation(SGP 2013)。
- Quadrangulation of Non-Rigid Objects using Deformation Metrics(2018)。
- Mac 端 GPT 的边流分析:top01_edge_flow_analysis_zh-CN.md。